公開日:
公式ドキュメント・公式発表などの一次情報を確認したうえで、株式会社Nexaが執筆・更新しています。AIツールの仕様や料金は変わることがあるため、導入判断の前に各公式サイトの最新情報もご確認ください。運営会社について
Llama 4はMetaが公開した画像と文章を扱うAIモデル群です。ScoutとMaverickの2モデルを、用途と運用条件で選びます。
- モデルの違い:Scoutは最大10M、Maverickは最大1Mトークンのコンテキストを公表しています。
- 日本語の注意:日本語は公式の想定範囲外です。追加言語向けの学習条件と、品質や安全性の評価を確認します。
- 導入条件:重みの公開は運用費ゼロを意味しません。商用利用にもライセンスと利用ポリシーの条件があります。
対象読者:AIモデルを選定する開発者、情報システム部門、DX推進担当者
今日やること:モデル名を指定できる環境で、公開サンプルの回答品質を比較する
Llama 4は、画像を含む資料の分析や文章生成を、自社で選んだ実行環境に組み込みたいときの候補です。ただし、「無料で公開されている」「17Bで動く」「長文を入れられる」という説明だけで採用すると、費用や日本語品質の見積もりを誤ります。
同じ17Bでも、保存するモデル全体の大きさは違います。この記事では公式資料をもとに、ScoutとMaverickの仕様、商用利用、日本語、試し方を整理します。仕様確認日は2026年9月10日です。
Llama 4とは何か
Llama 4は、Metaが開発した画像と文章を入力できるAIモデル群であり、完成済みの業務アプリとは異なります。
AIモデルは、入力に応じて文章などを生成する処理の本体です。文書をアップロードする画面、利用者のログイン、社内データへのアクセス管理は、周辺のアプリやサービスが担います。Llama 4の重みが公開されているとは、学習済みの数値データを取得し、条件に従って自分の環境で使えるという意味です。
Metaの2025年4月5日の公式発表では、ScoutとMaverickの配布が案内されました。文章を扱う大規模言語モデル(LLM)の仕組みに、画像理解を組み合わせています。基礎概念を補いたい場合は、LLMの仕組みと企業活用も参考になります。
ScoutとMaverickはどう違うか
Scoutは長い入力を扱う設計、Maverickは汎用的な回答品質を重視する設計で、保存するモデルの規模も異なります。
Metaの公式モデルカードで示されている主な仕様は次のとおりです。Bは10億、Mは100万を表す単位です。コンテキスト長は指示調整済みモデルの公表値で、提供サービスの利用上限とは区別します。
| 項目 | Llama 4 Scout | Llama 4 Maverick |
|---|---|---|
| 有効パラメータ数 | 17B | 17B |
| 総パラメータ数 | 109B | 400B |
| エキスパート数 | 16 | 128 |
| 公表コンテキスト長 | 10Mトークン | 1Mトークン |
| 入力 | テキスト、画像 | テキスト、画像 |
| 出力 | テキスト、コード | テキスト、コード |
| 知識のカットオフ | 2024年8月 | 2024年8月 |
長い公開資料をまとめて読ませるならScoutから、画像説明や対話の回答品質を比較するならMaverickも候補にします。ただし、名称や表の数字だけで優劣は決まりません。同じ質問を入力し、正確さと待ち時間を比べる必要があります。
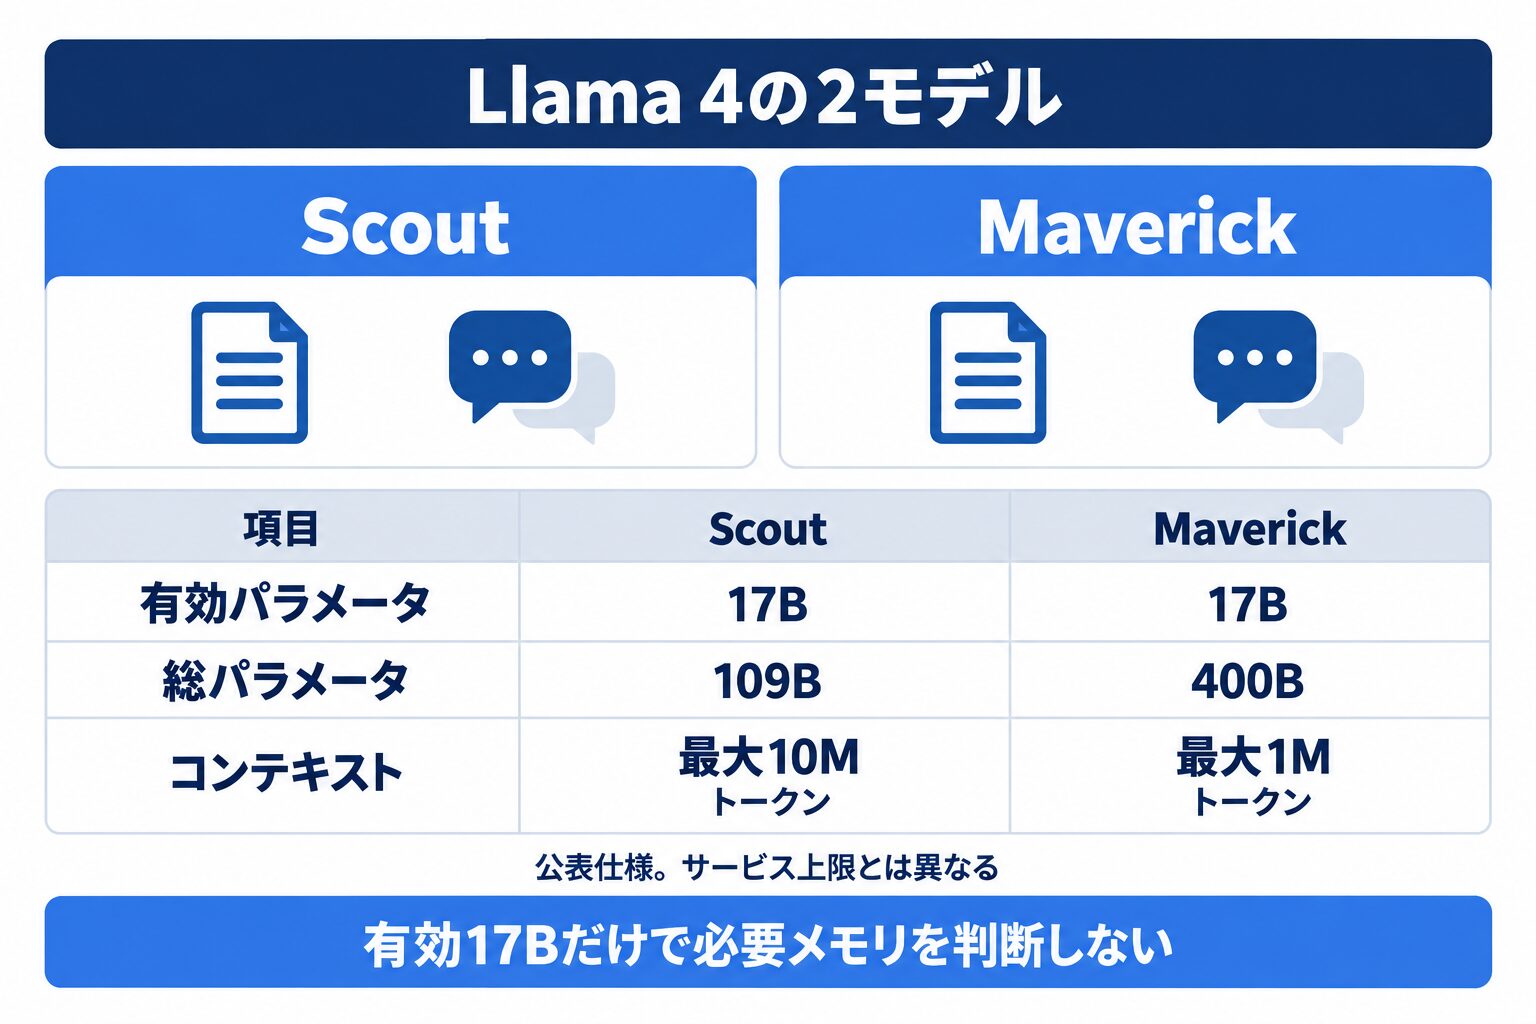 図1:有効パラメータ数とモデル全体の規模、コンテキスト長は別々に確認します。
MoEとはどんな仕組みか
MoEは入力ごとに使う処理部分を選ぶ仕組みで、計算量を抑えますが、モデル全体の保存容量が小さくなるとは限りません。
MoE(Mixture of Experts)は、複数の処理部分を持ち、入力の断片に応じて一部を選択する構造です。その処理部分をエキスパートと呼びます。人間の専門家が回答しているわけではなく、ニューラルネットワーク内部の仕組みです。
MetaはMaverickについて、共有エキスパートと、128個から選ばれるエキスパートが入力を処理すると説明しています。一度の処理で有効になる規模は17Bでも、総パラメータは400Bです。「17Bの小型モデルと同じメモリで動く」と読み替えることはできません。GPUを選ぶ際は、有効パラメータ数より先に総規模と保存形式を確認します。
1000万トークンで何が変わるか
Scoutの10Mトークンは長い資料を入力できる公表値であり、全内容の正確な理解や同じ長さの出力を保証しません。
トークンは、モデルが文章などを処理するときの分割単位です。日本語の1文字が必ず1トークンになるわけではありません。コンテキストには入力した資料だけでなく、指示や会話履歴なども関係するため、文字数の上限として扱わないようにします。
長文を一括で渡せれば、複数資料の比較や、離れた箇所の条件を照合する用途を検討できます。一方で、入力処理の時間、メモリ、サービス側の上限は別問題です。冒頭、中ほど、末尾にある根拠を正しく引用できるか、段階的に入力を長くして確認します。最大長を使い切ること自体を導入目標にする必要はありません。
Llama 4は日本語に対応しているか
公式対応12言語に日本語は含まれないため、日本語の回答が出ることと、日本語業務への適合は分けて判断します。
公式モデルカードの対応言語は、英語、アラビア語、フランス語、ドイツ語、ヒンディー語、インドネシア語、イタリア語、ポルトガル語、スペイン語、タガログ語、タイ語、ベトナム語です。事前学習はより広い言語を含みますが、それを日本語の公式対応と同一視できません。
公式モデルカードは、明記された対応言語以外の利用を「Out-of-scope(想定範囲外)」に分類しています。そのうえで、追加言語へのファインチューニングを、ライセンスと利用ポリシーに従う条件で認めています。ファインチューニングは、目的に合うデータでモデルを追加学習する方法です。
日本語で回答が出ることや、少数の品質試験に合格することだけで、公式の想定用途になるわけではありません。日本語業務への導入では、追加言語への適応方針、必要な調整、品質と安全性の評価を別々に検討します。敬語だけでなく、否定条件、単位、固有名詞、表の読み取りも確認し、対応が難しければ別モデルを選びます。
画像やPDFをどこまで扱えるか
Llama 4は画像と文章を入力して文章を返すモデルであり、画像生成やPDF処理の全工程を単体で提供するものではありません。
図表について質問する、画像の説明文を作る、複数画像の差を説明するといった用途が想定されています。PDFはファイル形式なので、利用するアプリ側でページを画像にするか、文章を取り出す処理が必要になる場合があります。PDFを渡せるかどうかは、モデル名だけでなく利用サービスの機能で確認します。
公式モデルカードの画像理解テストは、入力画像5枚までと記載されています。発表ブログには別の評価条件の説明もあるため、「どんな画像でも何枚でも扱える」とは書けません。実務ではまず少数の公開画像を使い、小さい文字、回転した表、似た品番の取り違えを点検します。
Behemothも使えるのか
Behemothは2025年4月の発表時に教師モデルとして紹介されたため、ScoutやMaverickと同じ配布モデルとして扱いません。
教師モデルは、別のモデルの学習を助けるために利用する大型モデルです。MetaはBehemothを、Llama 4の開発に使ったモデルとして説明しています。発表時には学習中で、まだ公開しないことも明記していました。
導入計画では、発表資料に名前が載っているだけのモデルを利用候補に数えないようにします。本記事は取得先と仕様を確認できるScoutとMaverickを対象にしています。Behemothについては、最新の公式配布先と利用条件を別途確認できた場合に限って検討します。
Meta AIでLlama 4を試せるのか
Meta AIを開くだけではLlama 4の評価になりません。製品が使うモデルと、指定して検証する配布モデルは別物です。
2025年のLlama 4発表には、Meta AIで試せるとの案内がありました。しかし、2026年4月のMuse Spark公式発表では、Meta AIアプリとWebサイトをMuse Sparkが動かすと説明されています。古い記事の手順をそのまま使うと、別モデルを評価しかねません。
ScoutとMaverickを比較するときは、モデルIDを明示できる推論サービスや、自分で配置した環境を使います。評価記録にも「Meta AI」ではなく、選択した正式なモデル名と提供元を残してください。
Llama 4は無料で使えるか
ライセンス上の利用料と実行費は別です。条件付きで重みを利用できても、APIやGPUの運用費がなくなるわけではありません。
MetaのHugging Face配布ページでは、利用条件を確認したうえでモデルへアクセスする手続きが案内されています。公開されているからといって、無条件に取得してよいという意味ではありません。
| 利用方式 | 主に確認する費用 | 見落としやすい費用 |
|---|---|---|
| 外部の推論API | 入出力の使用量、予約容量など | 長文入力、再試行、ログ保存 |
| クラウドで自己運用 | GPU、メモリ、ストレージ | 待機中の稼働、ネットワーク、監視 |
| 自社設備で自己運用 | 機器調達、電力、保守 | 障害対応、更新作業、担当者の工数 |
APIとは、プログラムからモデルへ処理を依頼する窓口です。料金は提供元や契約条件によって変わるため、特定の無料枠をLlama 4共通の条件として予算に入れないようにします。見積もりには利用量だけでなく、品質確認にかかる人の時間も含めます。
商用利用と再配布の条件は何か
Llama 4は商用利用を想定していますが、独自ライセンスの表示義務や利用制限があり、無条件の商用利用ではありません。
Llama 4 Community License Agreementは、条件付きで利用、改変、再配布などを認めています。MITやApacheと同じ条件のライセンスだと考えず、自社の提供形態に照らして確認します。
- モデルや派生物、それを含む製品やサービスの提供時は、契約文の提供や「Built with Llama」の表示条件を確認する
- モデルや出力を使ってAIモデルを作成、学習、追加学習、改良し、配布や提供をする場合は、名称の先頭に「Llama」を含める条件を確認する
- 配布するモデルのコピーには、指定されたNoticeの表示を保持する
- Llama 4のリリース時点で、その前暦月の利用者や関連会社の製品などの月間アクティブ利用者が7億人超なら、Metaへ申請し明示的な許諾を得る必要がある
Acceptable Use Policyも契約に組み込まれています。EUに住所を置く個人や、主たる事業所がEUにある企業へのマルチモーダルモデルの制限があり、組込み製品のエンドユーザーには例外が記されています。無保証、第三者請求に関する補償、契約終了時の使用停止や削除も、担当部門による原文確認の対象です。
ローカルで動かす必要スペック
Llama 4の自己運用は大型モデルを扱う設備が前提であり、一般的な業務用PCで簡単に動くモデルとしては案内できません。
Metaが示すScoutの単一H100 GPUでの実行は、Int4量子化を使う条件です。MaverickはFP8版が単一のH100 DGXホストに収まるという説明で、GPU1枚という意味ではありません。量子化とは、モデルの数値を低い精度で保持してメモリ使用量を減らす方法です。形式と実装によって品質や速度への影響が変わります。
TransformersのLlama 4公式文書も、一般的な端末には収まらない大型モデルであると注意しています。CPU側へ一部を移す方法もありますが、通信が増えて遅くなる可能性があります。モデルの保存分に加え、長文処理中の作業領域と同時利用数を見込んで設備を評価します。
APIと自己運用はどちらを選ぶか
小さく品質を試す段階ではAPI、配置場所や運用を細かく管理する必要がある場合は自己運用を候補にします。
Amazon BedrockのMetaモデル案内には、ScoutとMaverickが掲載されています。マネージドサービスではモデルを動かす基盤の管理負担を減らせますが、自社のデータ利用規程や利用権限の設計が不要になるわけではありません。
| 判断項目 | 推論API | 自己運用 |
|---|---|---|
| 初期検証 | 設備を持たず始めやすい | 環境構築と容量確認が必要 |
| 配置や更新 | 提供元の範囲から選ぶ | 自社側で管理できる範囲が広い |
| 上限や終了予定 | サービス仕様を確認する | 実装と保守体制を確認する |
| 障害対応 | 提供元と自社で分担する | 基盤を含む対応体制が必要 |
APIを選ぶ場合は、リージョン、データ保持、上限、モデルのライフサイクルを契約前に確認します。2025年の提供開始ニュースだけを、現在の全リージョンでの利用可否の根拠にしないようにします。
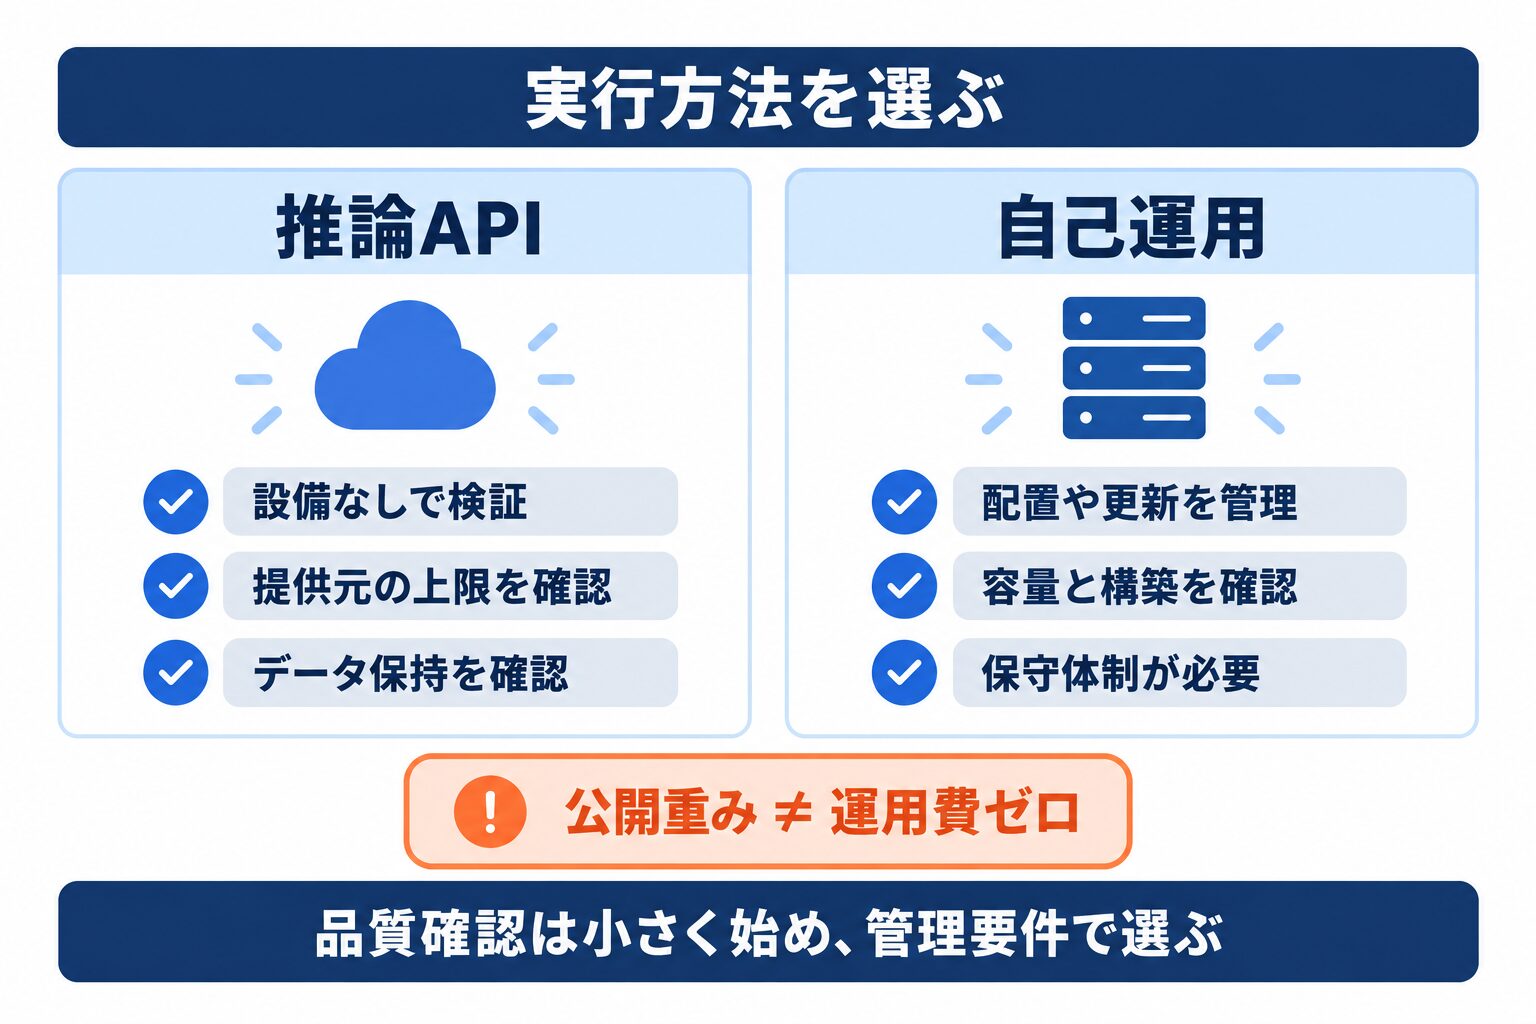 図2:推論APIと自己運用では、自社で管理する範囲と必要な費用が異なります。
Llama 4を試す手順
最初は公開データを少量だけ使い、モデル名と評価基準を固定して試すと、費用と品質の判断を進めやすくなります。
1. 入力データと正解を準備する
公開資料や利用権を確認したテストデータから始めます。要約なら残すべき事実、画像なら読み取るべき項目を、人が先に書いておきます。最初から個人情報や秘密情報を入力せず、回答の採点ができるデータを選んでください。
2. 実行環境とモデル名を確定する
推論サービスでは、利用条件と課金を確認してからモデルを選びます。AWSのMaverickモデルカードには、モデルIDやAPIの案内があります。利用可能な環境であることは、自社アカウントでも確認が必要です。
自己運用では、公式の配布元、量子化形式、推論ソフトの対応状況を揃えます。指示に答える用途なら「Instruct」のモデルを確認します。Instructは、指示への応答に向けた追加調整済みのモデルを示す名称です。
3. 短い入力から比較を始める
同じ資料と指示をScout、Maverick、比較対象のモデルへ渡します。次の文面は評価用の指示例であり、推論を実行した結果ではありません。
以下の公開資料だけを根拠に回答してください。資料にない事項は「確認できません」と記載してください。要約を3点、その根拠となる箇所を各1つ示してください。数値、単位、対象期間は元の表記を保持してください。回答後に、資料から判断できない点を列挙してください。【公開資料】ここに利用権を確認した短い資料を挿入4. 入力を増やして利用条件を記録する
短い資料で基準を満たしてから、長文や画像を追加します。記録にはモデルID、提供元、入力の長さ、設定、回答時間、利用量を残します。本記事ではLlama 4の推論実測やGPU性能測定は行っておらず、速度や精度の保証値は示していません。
日本語の業務品質をどう測るか
日本語の評価では文章の自然さだけでなく、事実の保持、根拠の提示、分からないと答える動作を別々に採点します。
以下は社内検証のための評価表です。数値目標は一律に決めず、誤りが起きた場合の影響と、人が確認できる範囲に合わせて設定します。自然な文章に言い換えるほど、条件や数値の抜けが見えにくくなる場合があります。
| 評価項目 | テストする内容 | 不合格の例 |
|---|---|---|
| 事実保持 | 金額、期間、例外条件を残す | 単位を変える、但し書きを落とす |
| 根拠提示 | 回答を元資料へ結び付ける | 実在しない見出しを引用する |
| 日本語表現 | 敬語、否定、主語を正しく扱う | 禁止事項を推奨として要約する |
| 不明時の対応 | 資料にない質問を混ぜる | 外部知識で断定して補う |
| 再現性 | 同条件で複数回比較する | 回答ごとに重要条件が変わる |
人が修正した後の成果物だけで評価せず、修正に要した時間と誤りの種類も残します。追加調整が必要なら、その作業量を運用費へ戻して採用判断を見直します。
長文処理とRAGはどう使い分けるか
固定された少数の長い資料には長文入力を試し、更新や閲覧権限の管理が必要な資料群には検索との組み合わせを検討します。
RAG(検索拡張生成)は、質問に関連する資料を検索し、その内容をモデルへ渡して回答させる方式です。モデルに社内文書をすべて記憶させる方法ではありません。Llama 4を回答生成の部分に使っても、検索の品質や権限チェックは別に設計します。
例えば、公開済みの固定レポートを比較するなら、一括入力でも検証できます。一方、部署ごとに閲覧範囲が異なる規程集では、検索時点で権限を絞り、更新日や出典を付ける設計が必要です。長いコンテキストを持つことは、不要な文書や権限外の資料を渡してよい理由にはなりません。
情報漏洩と誤操作をどう防ぐか
自社で動かす場合でも、アクセス権限とログ管理を整え、外部操作の承認をモデル任せにしない設計が必要です。
自己運用なら外部送信が一切発生しない、とは限りません。周辺の監視、外部ツール、画像URLの取得など、モデル以外の通信先も点検します。APIではデータ保持や再利用の条件を確認し、保存するログの内容と期間を決めます。
Metaのモデルカードは、モデル単独ではなく追加の保護を備えたシステムとして使うことを勧めています。Llama GuardやPrompt Guardなどの保護機能も紹介されていますが、導入すれば事故を防げるという保証ではありません。メール送信やデータ変更を連携する場合は、人間の承認とアプリ側の権限チェックを置きます。
動かないときに確認すること
実行エラーは認証、メモリ、ソフトの互換性、入力条件に分けて調べると、モデルの問題と環境の問題を切り分けられます。
| 症状 | 先に確認すること | 対応の方向 |
|---|---|---|
| ダウンロードできない | 配布条件への同意、アクセス許可 | 正規アカウントの承認状態を確認 |
| 読み込み時に停止する | 総メモリ、保存容量、量子化形式 | 対応する構成を選び直す |
| 未対応モデルと表示される | 推論ソフトとモデル形式 | 公式対応表と導入版を照合 |
| 長文だけ失敗する | サービス上限、作業領域 | 短い入力へ戻して段階的に増やす |
| 画像だけ失敗する | 画像形式、サイズ、入力方式 | 正常な少数画像で再確認 |
| 日本語の誤りが多い | 対応範囲、指示、評価結果 | 別モデルか追加調整を検討 |
認証エラーを回避するために他人のキーを借りたり、メモリ不足を理由に安全設定を外したりする必要はありません。障害報告には秘密情報を除いたエラー文と構成を添えます。APIなら提供元の利用上限、自己運用なら実際のソフト構成を先に確認します。
企業導入前のチェックリスト
採用前には用途、日本語品質、実行費、ライセンス、運用責任の5項目を確認し、条件を満たさない点を残さず判断します。
- 用途:画像理解や長文処理が必要か、小型の別モデルでも目的を満たせないか
- 日本語品質:否定、数字、単位、根拠を保持でき、誤りを人が確認できるか
- 実行費:通常の利用量だけでなく、長文、再試行、監視、保守を見積もったか
- ライセンス:利用形態に応じた表示、再配布、地域、禁止用途の条件を確認したか
- 運用責任:更新、障害、権限、データ保持、サービス終了時の移行を誰が管理するか
この5項目は、Llama 4の性能を否定するためのものではありません。公開モデルの柔軟性を使うほど、自社で決める範囲も増えます。小規模な検証で未達項目を特定し、改善費用を含めても採用する理由があるかを判断します。
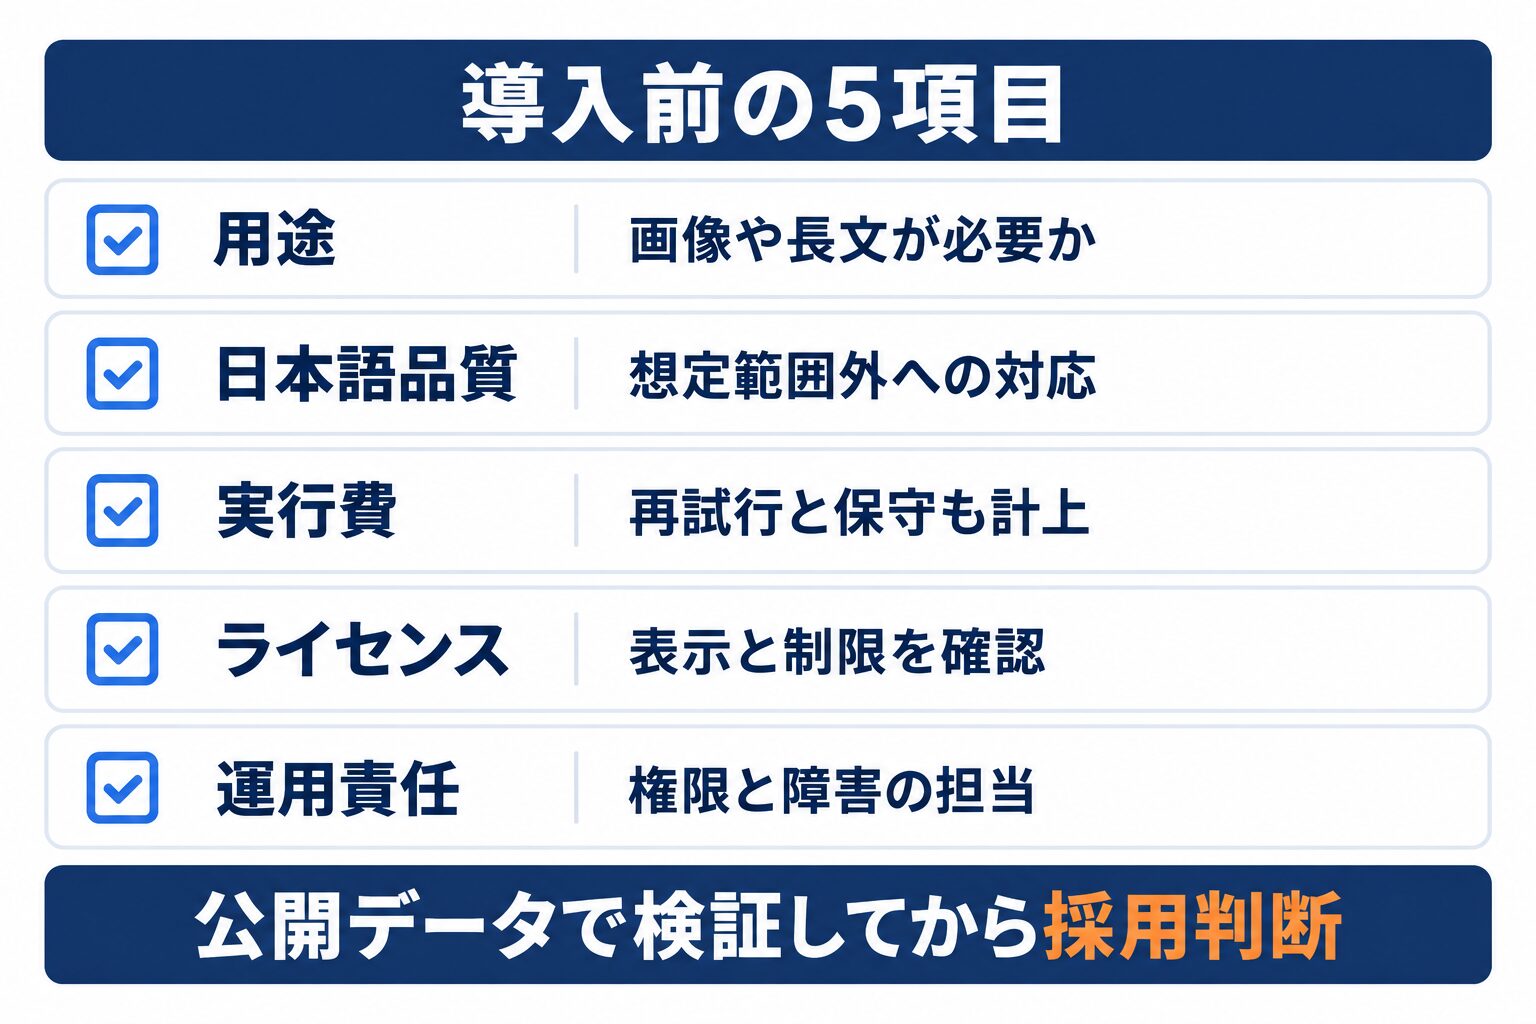 図3:用途、日本語品質、実行費、ライセンス、運用責任の5項目で採用を判断します。
Llama 4のよくある質問
無料、日本語、実行環境の判断はモデル名だけでは決まりません。公式仕様と、実際に使うサービスの条件を分けて確認します。
Q. Llama 4はオープンソースですか?
学習済み重みが公開されたオープンウェイトのモデルです。ただし独自のCommunity Licenseと利用ポリシーがあり、無条件に使えるソフトウェアではありません。商用提供や再配布では原文の条件を確認してください。
Q. Llama 4で画像を生成できますか?
本記事で扱うScoutとMaverickの公式仕様では、出力はテキストとコードです。画像を理解することと画像を生成することは異なります。画像を新たに作るには別の生成モデルやサービスが必要です。
Q. Llama 4は普通のノートPCで動きますか?
一般的な業務用ノートPCでの簡単な実行を前提にしないでください。モデル全体が大きく、量子化やメモリ構成の検討が必要です。最初の品質確認には、モデル名を指定できるAPIを使う方法があります。
Q. 日本語で回答すればそのまま導入できますか?
その判断はできません。日本語は公式モデルカードで想定範囲外に当たり、回答が自然でも公式対応とはなりません。追加言語へのファインチューニングに関する条件を確認し、適応方針と品質・安全評価を検討してください。
Q. Scoutの1000万トークンをAPIでも使えますか?
提供サービスの仕様によります。モデルの公表コンテキスト長が、そのままAPIの利用上限になるとは限りません。選択するモデルID、リージョン、アカウントの上限を確認し、少量から試します。
まとめ
Llama 4を選ぶときは、ScoutとMaverickの違いだけでなく、日本語品質と運用条件を同じ評価表で比較します。
長い入力や画像理解を、自分で選んだ環境に組み込める点は検討材料です。一方、有効17Bという表示は小さなメモリでの実行を保証せず、公開重みも運用費ゼロを意味しません。Meta AIの現在の応答を、そのままLlama 4の評価とすることも避けます。
まずは公開資料の要約や画像説明を1用途選び、正解と採点項目を用意してください。品質、費用、ライセンスを確認してから、実際の業務データを扱う段階へ進めます。
AI導入に関するお困りごとをサポートします
株式会社NexaのAI顧問は、ツール選定から業務への適用、社内定着までを月額制でサポートします。特定のツールに限らず、「AIをどう使えばいいか分からない」という段階からご相談いただけます。
この記事で参照した外部情報
- Metaの2025年4月5日の公式発表ai.meta.com
- Metaの公式モデルカードgithub.com
- 2026年4月のMuse Spark公式発表about.fb.com
- MetaのHugging Face配布ページhuggingface.co
- Llama 4 Community License Agreementgithub.com
- Acceptable Use Policygithub.com
- TransformersのLlama 4公式文書huggingface.co
- Amazon BedrockのMetaモデル案内aws.amazon.com
- AWSのMaverickモデルカードdocs.aws.amazon.com
本文中でリンクしている外部ページの一覧です(自動生成)。最終確認日は本記事の最終更新日 2026-09-10 で、リンク先の内容はその後変わることがあります。