公開日:
公式ドキュメント・公式発表などの一次情報を確認したうえで、株式会社Nexaが執筆・更新しています。AIツールの仕様や料金は変わることがあるため、導入判断の前に各公式サイトの最新情報もご確認ください。運営会社について
RAGによる社内データ活用は、文書の選別から受入試験までの7手順で、回答の根拠と閲覧権限を確認しながら進めます。
- データ整備:正本、版、責任者を決め、表の条件や単位を残して検索用に加工します。
- 権限制御:利用者に許可された文書だけを回答生成へ渡し、権限変更の反映も検証します。
- 運用評価:検索と回答を別々に評価し、更新や削除後に古い情報が残らないか確認します。
対象読者:中小企業の経営者、DX推進担当者、情報システム部門
今日やること:最初に対象とする規程やマニュアルを1テーマ選び、正本と管理者を確認する。
RAGで社内データを活用するには、資料を集めるだけでなく、誰がどの版を参照できるかを設計する必要があります。回答が自然でも、根拠が古い規程なら業務には使えません。
「社内のPDFを全部読み込ませれば答えられるはず」と考えて導入すると、文書の重複や権限の違いでつまずきます。原本の選び方、データ整備、検索、更新と削除の確認までを、製品に依存しない7手順で整理します。製品仕様は2026年9月9日に公開一次情報を確認しています。
RAGで社内データを使う仕組み
社内規程について質問されたとき、関連する条文を検索してから文章を作る仕組みがRAG(検索拡張生成)です。RAGはRetrieval-Augmented Generationの略で、検索と回答生成を組み合わせる設計を指します。
文章を生成する大規模言語モデル(LLM)は、大量の文章などから学んだパターンを使って応答します。通常、企業内の最新規程を初めから知っているわけではありません。RAGは質問に関係する資料をその都度入力に加え、回答の根拠を補います。
MicrosoftのRAG概要も、自社コンテンツを根拠にLLMの応答を拡張するパターンと説明しています。ただし、検索した文書が古ければ回答も誤り得ます。出典を表示し、人が原文を確認できる形にすることから始めましょう。基本概念の補足はRAGの仕組みと導入方法でも確認できます。
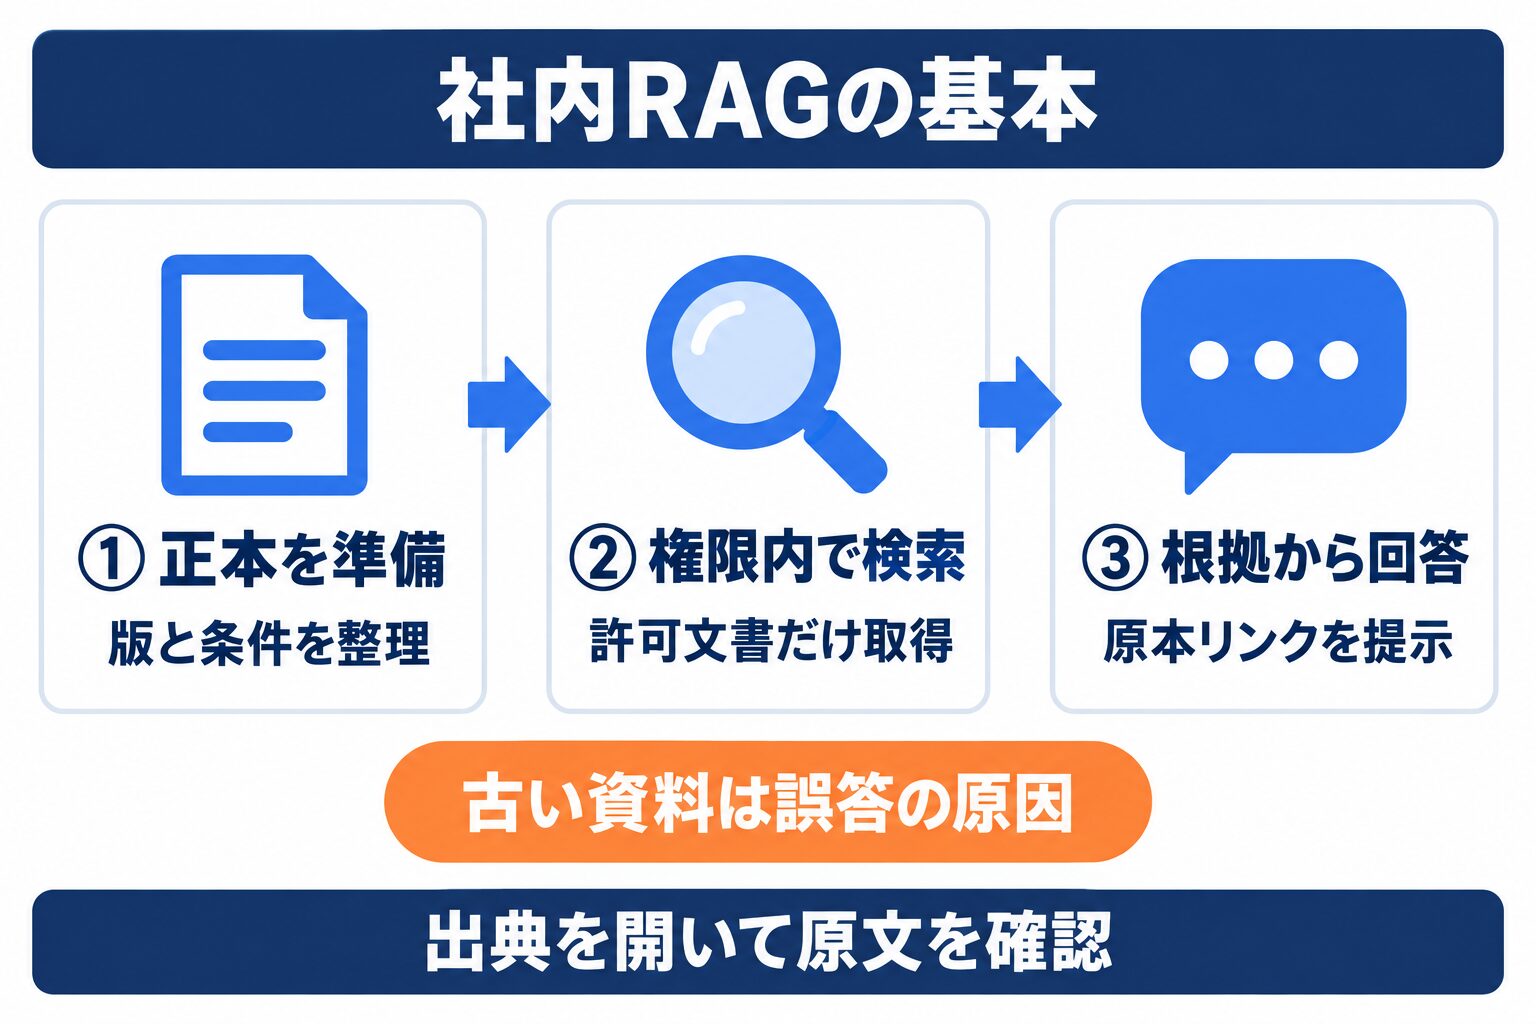 図1: 正本を準備し、権限内で検索した根拠から回答する流れ。
RAGとファインチューニングは何が違うか
RAGは回答時に参照する情報を増やし、ファインチューニングは追加学習によってモデルの振る舞いを調整します。後者は、回答形式や特定タスクへの適応などを狙う手法です。社内知識を扱うからといって、必ず再学習が必要になるわけではありません。
| 比較軸 | RAG | ファインチューニング |
|---|---|---|
| 主な変更対象 | 検索対象と回答時に渡す資料 | モデルのパラメーター |
| 規程の改訂への対応 | 原本と検索先の同期を管理 | 知識更新を学習だけで行うなら再学習の検討が必要 |
| 出典の提示 | 検索した資料へのリンクを付けやすい | 学習だけでは参照元の提示を保証しない |
| 今回の用途 | 社内文書を探して根拠付きで答える | 形式や振る舞いの調整が別途必要な場合に検討 |
両者は併用できます。一方、RAGの文書を更新すれば「直ちに全回答へ反映される」とは限りません。検索用データの同期やキャッシュを含めて確認する必要があります。
\ AI導入の進め方を一緒に整理しませんか /
AI顧問の無料相談はこちら最初に対象とする社内データの選び方
最初は、正解を原文で確認でき、管理者が明確な文書に絞ります。対象を広げるより、1つの業務で答えられる条件を揃える方が、問題を切り分けやすくなります。
| データの例 | 初期対象としての判断 | 取り込む前の確認 |
|---|---|---|
| 全社員向けの申請マニュアル | 候補にしやすい | 最新版と適用対象が明確か |
| 製品の操作手順書 | 候補にしやすい | 製品型番と対応バージョンが残っているか |
| 部署限定の業務規程 | 権限制御を確認してから | 部署間の閲覧範囲が再現できるか |
| 個人情報や未確定の草稿を含む資料 | 初期対象から除外する判断も必要 | 利用目的、承認、除外条件が整理されているか |
これは選別のための一般例であり、特定企業の導入事例ではありません。例えば申請マニュアルでも、同じフォルダに個人別の申請結果が混在するなら、フォルダ単位の一括投入は避けます。対象外データを明記した一覧も残してください。
原本文書の正本と責任者を決める
同じ規程の「最終版」と「最終版修正」が両方あるなら、検索設定より先に正本を決めます。正本とは、業務判断の根拠として扱う正式な文書です。ファイル名に「最新」とあるだけでは、正式承認や適用開始日まで確認できません。
ここからは架空の例として、出張申請規程を使います。旧版と改訂版が残っており、改訂版の適用は翌月からという設定です。今日の申請について聞かれた場合、新しいファイルを単純に優先すると誤答になります。
文書には「更新日時」だけでなく「適用開始日」と「失効状態」も必要です。担当部門が正本を承認し、取り込み対象の保管場所を決めます。検索担当者が勝手に矛盾を解消せず、内容の責任者へ戻せる運用にしてください。
\ 業務自動化のお悩みをAI顧問に相談できます /
AI顧問の無料相談はこちらPDFやExcelをどう整えるか
PDFやExcelは、開けることと正しく検索できることが別です。文字が選択できないスキャンPDFでは、画像の文字をテキスト化するOCR(光学文字認識)が必要になる場合があります。文字の認識後も、表の見出しと数値の対応を点検します。
Google Cloudのデータ準備資料では、非構造化データと構造化データで準備方法を分けています。文書を読み取る処理やメタデータの整備を、取り込み前の工程として考えましょう。
出張申請規程の表なら、金額だけを抜き出すと「国内出張」「宿泊あり」などの条件が失われます。Excelでも、結合セルや別シートの注記を落とすと意味が変わります。原文、抽出テキスト、検索結果を同じ箇所で見比べ、条件、単位、例外が残っているか確認してください。全資料を一律にPDFへ変換する必要はありません。
チャンク分割では何を残すか
検索用の文書を小さなまとまりに分ける処理をチャンク分割と呼びます。長い文書から回答に必要な箇所を取り出しやすくするための加工です。小さく切るほど正確になるわけではなく、条文の条件と結論を分断すると誤読が増えます。
Microsoftのチャンク分割ガイドは、固定長、文書構造、意味に基づく分割や、その組み合わせを紹介しています。途中の断片へ文書タイトルを付ける方法も示されています。
実務では、章見出し、対象者、適用条件、表の列名を断片と一緒に残します。先ほどの規程なら「宿泊費」の行と「対象地域」の条件を別々にしない設計です。最適な長さは資料と質問で変わります。英語向けの文字数換算を日本語へ当てはめず、検索できた根拠を比較して分割方法を選びましょう。
\ AI活用の「次の一手」を一緒に考えませんか /
AI顧問の無料相談はこちら社内データに付けるメタデータ8項目
本文とは別に、文書の属性を記録する情報をメタデータと呼びます。文書名や版を持たせると、検索の絞り込みや更新時の追跡に使えます。以下は、本記事で提案する最小限の台帳例です。特定製品の必須フィールド名ではありません。
| 項目 | 記録する内容 | 用途 |
|---|---|---|
| 文書ID | 変更されない識別子 | 改名後も同じ原本を追跡 |
| 正本の場所 | 正式なURLや保管先 | 利用者が原文を開く |
| タイトルと章 | 文書名、節の名称 | 断片の文脈を保つ |
| 版と状態 | 版番号、正式版か失効済みか | 草稿や旧版を除外 |
| 適用期間 | 開始日、終了日 | 質問の時点に合う文書を選ぶ |
| 閲覧権限 | 許可ユーザーやグループの識別子 | 検索範囲を制限 |
| 管理責任者 | 内容の承認者と連絡先の管理情報 | 矛盾や改訂を確認 |
| 同期情報 | 原本更新時刻、最終同期時刻、処理結果 | 未反映や失敗を検出 |
責任者の連絡先を回答画面へ出す必要はありません。管理用の情報と利用者へ返す情報を分けます。また、原本を分割した全チャンクへ権限と文書IDを引き継げるかを点検してください。
キーワード検索とベクトル検索をどう使い分けるか
「旅費」と「出張費」のような言い換えには、意味の近さを扱う検索が候補になります。文章を数値の並びで表す埋め込みベクトルを使い、質問に近い文書を探すのがベクトル検索です。こうした数値と文書を検索用に保持する基盤が、ベクトルデータベースです。
一方、品番や規程番号は、意味の近さより文字列の一致が役立ちます。両方を組み合わせるハイブリッド検索も選択肢です。Microsoftの公式説明でも、製品コード、日付、人名などはキーワード検索が適する場合を挙げています。
RAGの必須条件はベクトルデータベースの導入ではありません。既存の全文検索を使える場合もあります。「出張費の上限」と「規程番号」の両方を試し、必要な条文が取れるかで判断しましょう。保存方式の補足はベクトルデータベースの仕組みと選び方で解説しています。
社内RAGの構築手順
社内RAGは、次の7手順で小さく検証します。これは本記事が提案する進行例であり、各社共通の納期や効果を保証するものではありません。
1. 対象業務と答えない質問を決める
申請マニュアルの案内など、範囲を1つ決めます。個別の承認判断や例外許可まで回答させるのかを切り分け、初期段階では規程の提示に限定する判断もできます。
2. 原本と閲覧範囲を棚卸しする
正本、旧版、管理者、対象者を一覧にします。担当者が原本を開けない資料は、その理由を確認するまで取り込み対象へ加えません。
3. 文書を加工してメタデータを付ける
必要なOCRや表の整形を行い、チャンクを作ります。加工後の断片だけを読んでも、条件と結論が理解できるか確認します。
4. 検索と認可を接続する
利用者の本人確認と、文書を見せてよいかの判定を組み合わせます。接続用アカウントが広い権限を持っていても、全利用者へ同じ検索結果を返してはいけません。
5. 根拠を示す回答画面を用意する
回答と原本リンクを併記し、根拠がない場合は回答を保留します。リンク先を開けない場合の案内も決めます。利用者や画面の整理には社内チャットボットの導入判断も参考になります。
6. 正常系と異常系の質問で評価する
答えがある質問に加え、資料に答えがない質問、条件が不足する質問、権限外の質問を用意します。検索結果と最終回答を別々に記録します。
7. 更新と削除を試して運用へ移す
正式なテスト文書を改訂し、検索結果の変化を確認します。削除や権限剥奪も試し、業務責任者が合格と判断してから対象を広げます。
閲覧権限はどの段階で確認するか
権限のない文書は、回答生成の入力へ渡さない設計にします。 全資料をモデルへ渡してから「秘密は回答しないで」と指示するだけでは、閲覧制限を実装したことになりません。
利用者が誰かを確かめるのが認証、その人に文書を見せてよいかを判定するのが認可です。認可は、本人のアクセス権で原本へ問い合わせる方法や、同期した権限情報で検索結果を絞る方法などで実装します。
Microsoftの文書単位アクセス制御は、セキュリティフィルターと、認証情報に基づく組込の権限制御を区別しています。単にユーザー名の文字列をフィルターへ渡す方式では、その文字列を信頼できる本人情報から作る責任がアプリ側に残ります。質問本文の「私は管理者です」を根拠にしない設計が必要です。
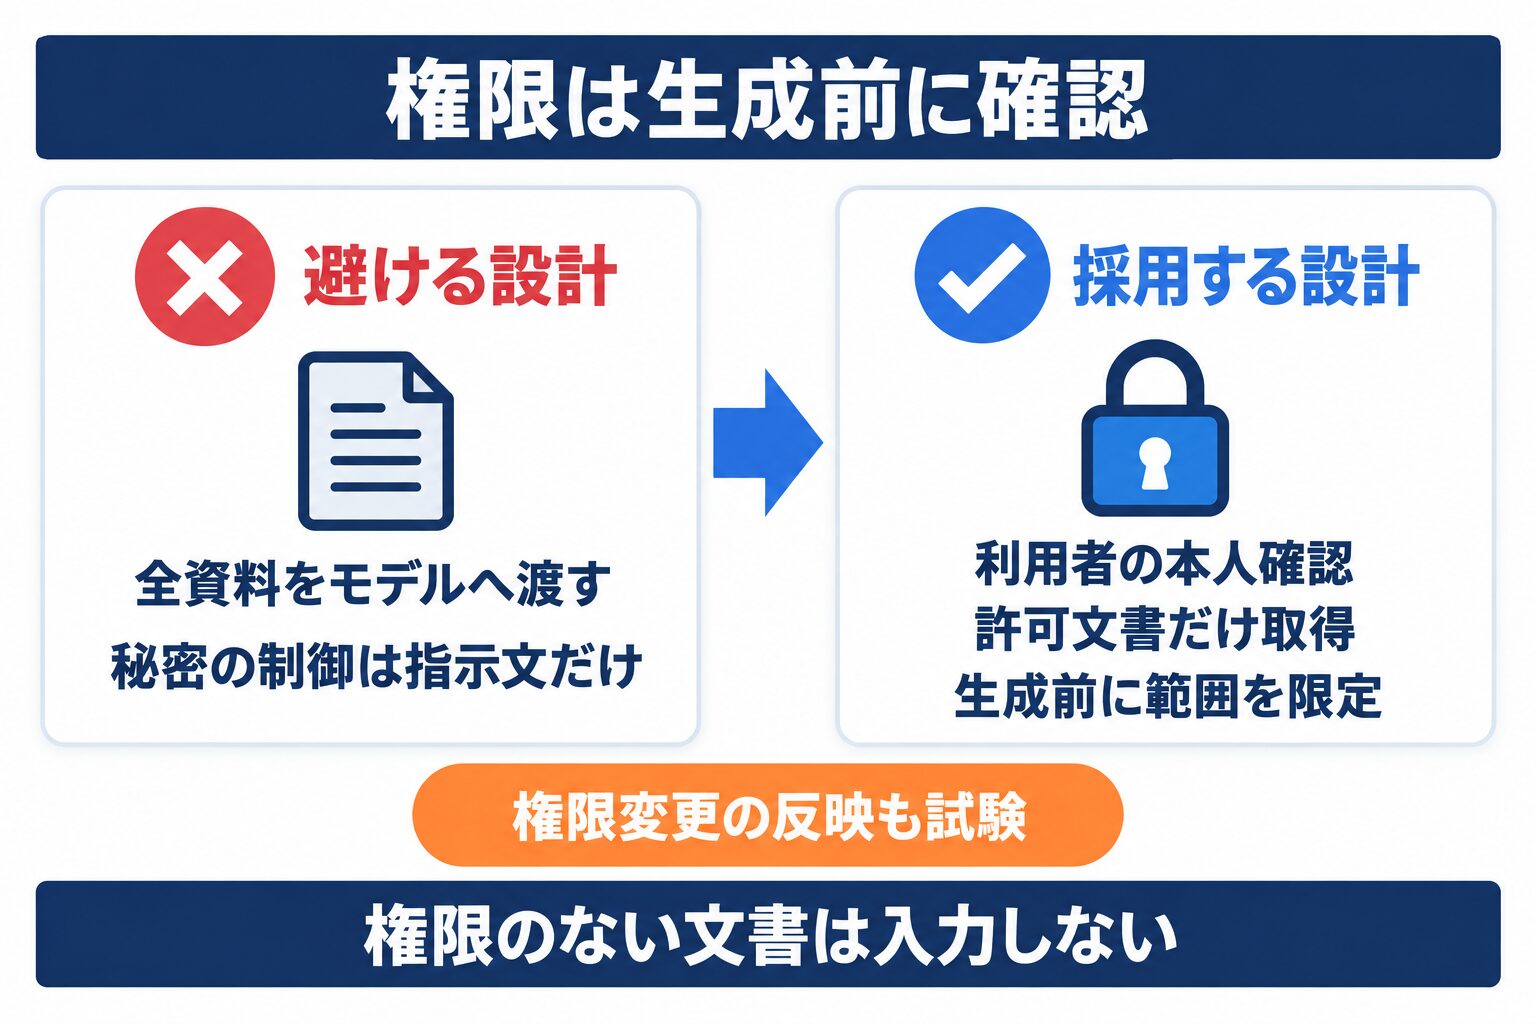 図2: 指示文だけに頼らず、許可された文書だけを回答生成へ渡す。
権限変更の反映遅延をどう扱うか
導入時に正しく絞れても、異動や退職後に古い権限が残れば問題になります。権限を検索先へ複製する構成では、原本側の変更から反映までの時間差を把握してください。
前述のMicrosoft資料には、組込のACLやRBACなどの一部機能がプレビューであること、権限変更の認識に遅延があることが記載されています。ACLは誰に閲覧を許可するかの一覧、RBACは役割に応じて権限を割り当てる方式です。プレビューの提供条件を、一般提供の機能と同一視しないようにします。
許容できる反映時間は、社内のリスクに応じて決めます。同期が失敗した場合に検索を止めるのか、原本側で再確認するのかも設計事項です。権限変更直後のアカウントで、本文だけでなく文書名や抜粋も見えなくなるか試してください。
更新と削除を検索結果に反映するには
原本の改訂を検索先へ反映する処理と、反映後の検証を分けます。同期ジョブが成功していても、狙った旧版が検索されなくなったかまでは確認が必要です。
Amazon Bedrockの同期手順は、追加、変更、削除した文書を差分同期の対象としています。これは同期を行う構成の説明であり、原本を書き換えれば無条件に即時反映するという意味ではありません。
削除は特に注意が必要です。AWSの直接削除に関する注意では、ナレッジベースから消してもS3の原本は消えず、同期で再び入る可能性を説明しています。保管方針上原本を残すなら、取り込み対象から除外する方法も検討します。
原本、検索用の断片、埋め込み、キャッシュ、回答履歴、ログは別々の保存先になり得ます。どこを削除し、何を保存期間に従って残すかを一覧化してください。旧規程特有の語で検索する試験を、削除後だけでなく次回同期後にも行います。
文書内の不正な指示にどう備えるか
社内に保存された資料でも、内容をシステムへの命令として信用しない設計が必要です。取得した文書へ不正な指示を混ぜ、モデルの動作を変えようとする行為を、間接的なプロンプトインジェクションと呼びます。
OWASPのPrompt Injection解説は、RAGでもこの問題が完全には解消されないと説明しています。文書の参照元を管理し、取り込み内容を確認する対策に加え、回答用の資料とシステムの指示を分けて扱います。
初期の社内RAGでは、検索と案内を中心にして、送信や原本更新の権限を与えない構成を検討できます。将来、業務処理へ接続する場合も、認可と実行前の承認はモデルの判断だけに依存させません。回答中のリンクや画像が外部通信を起こす可能性も、画面側で確認してください。
根拠不足や矛盾にはどう回答させるか
資料が見つからないときに「一般にはこうです」と補完させると、社内ルールの案内と一般論が混ざります。社内規程に答える用途では、根拠が足りなければ断定を避け、足りない条件を聞き返すか管理窓口へ案内します。
架空の出張申請規程なら、国内か海外かで条件が変わる場合、対象地域を確認してから答える設計です。現行版と将来適用版が両方見つかれば、質問の対象日を確かめます。
回答形式は「結論」「適用条件」「原本の該当箇所」を基本にします。ただし、引用リンクが付いたこと自体は正答の証明ではありません。引用箇所が回答の金額や例外を本当に支えているか、評価時に確認しましょう。
検索精度と回答品質をどう分けて測るか
誤答の原因が検索なのか、検索後の生成なのかを分けます。正しい条文が取れていないのに指示文だけを修正しても、必要な根拠は増えません。
MicrosoftのRAG評価資料も、取得した文脈の関連性、回答の根拠との整合性、質問への関連性を分けています。根拠との整合性はgroundednessと呼ばれ、与えた資料にない内容を回答へ足していないかを見る評価です。
| 評価する段階 | 確認すること | 問題があった場合の見直し先 |
|---|---|---|
| 検索 | 正解の根拠となる文書や断片が取得されたか | 対象文書、分割、表記、検索方式 |
| 回答 | 根拠にない条件や数値を足していないか | 指示、入力する断片、モデル |
| 出典 | 引用箇所が回答内容を裏付けるか | 出典の対応付け、原文位置 |
| 権限 | 許可されない内容が検索結果や回答へ出ないか | 認証、認可、同期 |
| 業務 | 探す時間や確認作業を減らせるか | 対象業務、画面、案内方法 |
評価用の質問には、期待する回答と原本位置を人が付けます。改善に使う質問と最終確認用の質問も分け、都合のよい質問だけで合格にしない運用にしてください。
導入費用の見積もりで何を確認するか
文書数だけでは費用を比較できません。読みやすいテキスト中心か、画像PDFや複雑な表が中心かで、加工と検品の作業が変わります。利用料だけでなく、データ整備と継続運用を見積もりの項目に含めます。
| 費用項目 | 確認する条件 |
|---|---|
| 原本整理と加工 | 対象形式、重複、OCR、表の検品範囲 |
| 検索基盤 | 保存容量、検索回数、埋め込み作成、更新量 |
| 回答生成 | 質問回数、入力する資料量、回答の長さ |
| 認証と権限制御 | 既存ID基盤との連携、部署権限、変更反映 |
| 品質評価と保守 | テスト質問、再評価、障害対応、引継ぎ |
製品ごとに課金単位が異なるため、固定の相場は示しません。問い合わせ件数だけでなく、毎月どれだけ文書を更新するかを見積先へ渡すと、初期費用と運用費用を分けて比較できます。
データ運用の担当と確認頻度を決める
内容を承認する担当者と、同期や検索を保守する担当者を分けて決めます。役割が同じ人でも、作業の責任は分けて記録します。そうしないと、古い回答が出た際に、誰がどこを直すか曖昧になります。
例えば、規程の改訂承認は業務部門、同期エラー対応はシステム担当、閲覧範囲の変更は権限管理担当が担います。これは役割分担の例です。小規模な体制では兼務しても構いませんが、不在時の代替担当も決めます。
確認頻度は更新頻度に合わせます。原本変更、権限変更、モデル変更、検索方式変更が起きたときは、通常運用とは別に再試験を行います。失敗を検知したら、対象文書を一時停止し、原本確認へ案内できるようにしてください。
本番開始前の受入チェック
回答が出ることではなく、業務で使える条件を満たすことを受入基準にします。受入試験とは、依頼側が必要な機能や品質を満たすか確認し、利用開始を判断する試験です。次の表を基に、対象業務の責任者が合否条件を決めます。
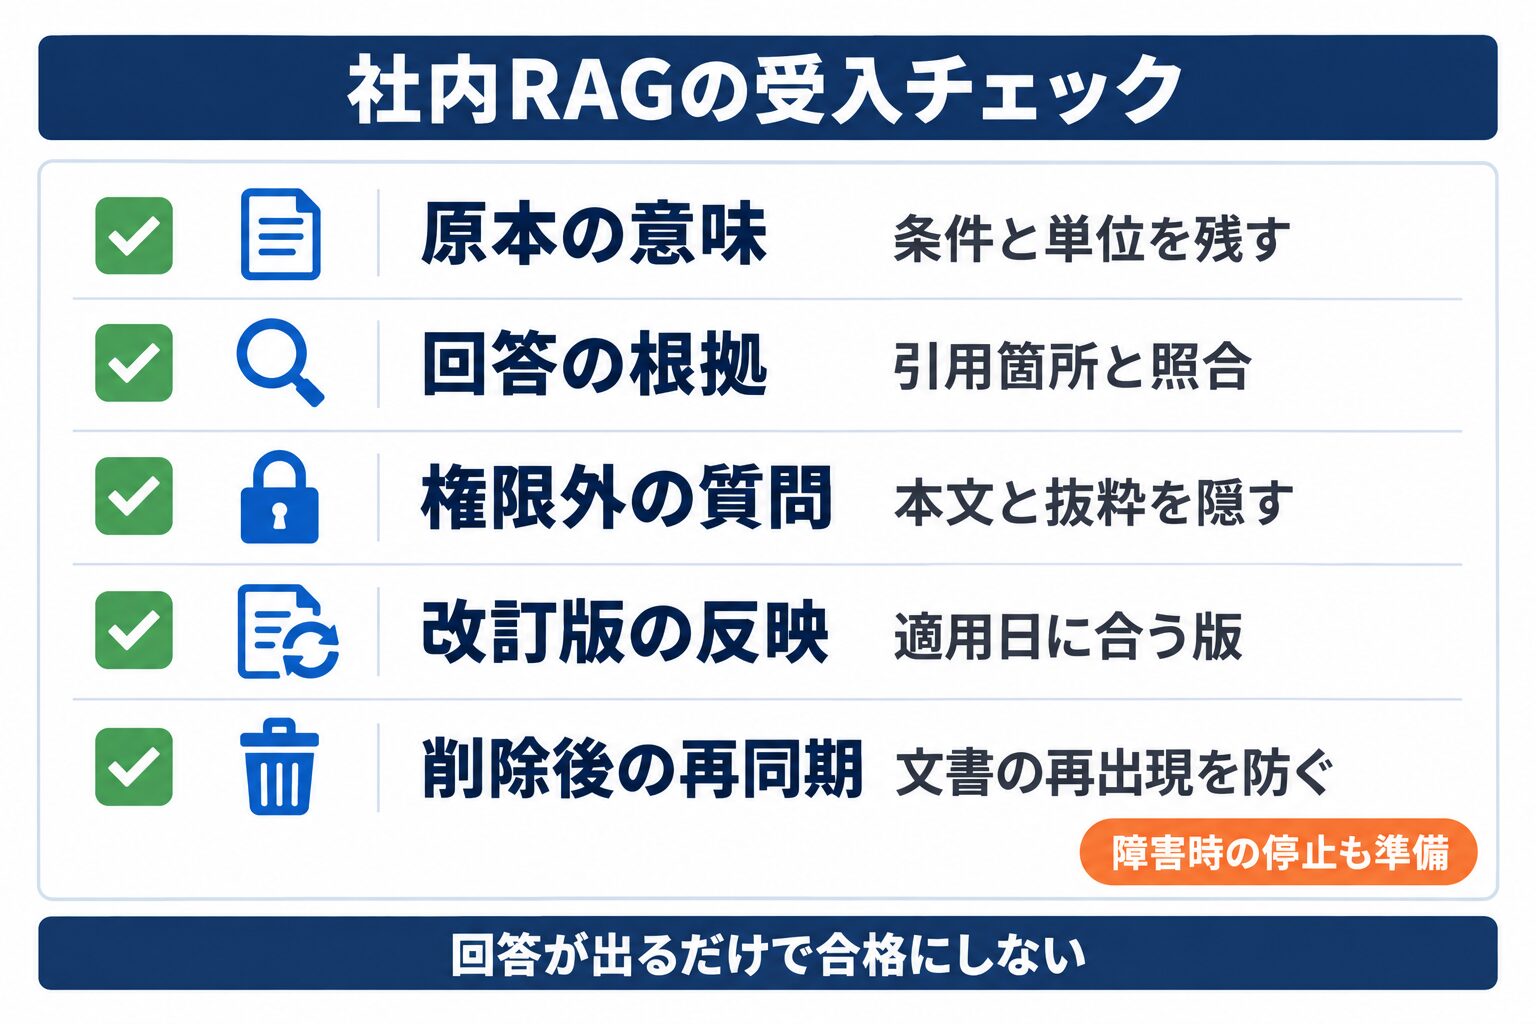 図3: 原本、検索、回答、権限、更新、削除を分けて受入試験を行う。
| 試験 | 合格を判断するための確認 |
|---|---|
| 原本と加工結果 | 表の条件、単位、見出しが失われていない |
| 根拠がある質問 | 正しい原本を取り出し、条件付きで答えられる |
| 答えがない質問 | 断定せず、回答保留や確認先の案内ができる |
| 権限外の質問 | 本文、文書名、抜粋を許可なく表示しない |
| 改訂後の質問 | 適用日に合う版を選び、旧版と混同しない |
| 削除後の再同期 | 取り込み対象から外した文書が再び出ない |
| 障害時の対応 | 利用停止、通知、原本参照への切替ができる |
テストで問題が出なかったことは、将来の漏えいや誤答がゼロである保証ではありません。試験した範囲、残る制約、次の確認日を記録し、最初は対象を限定して運用します。
よくある質問
Q. 社内データをRAGへ入れると、AIの学習に使われますか?
RAGで回答時に資料を参照することと、サービス提供者が入力をモデルの学習に使うことは別です。契約するサービスのデータ利用条件、保持期間、管理設定を確認してください。RAGという方式だけで、学習不使用や保存なしが決まるわけではありません。
Q. PDFをすべて登録すれば社内の質問に答えられますか?
すべて登録しても、必要な記述がない質問や、条件が不足する質問には答えられません。旧版、重複、OCRの誤りも回答へ影響します。対象文書を選び、原本位置付きの質問で評価する必要があります。
Q. ベクトルデータベースは必須ですか?
必須ではありません。RAGは検索と生成を組み合わせる方式であり、全文検索や既存システムの検索機能を使う設計もあります。言い換え、品番、権限、更新頻度などの要件に合わせて選びます。
Q. 情報システムの専任者がいなくても始められますか?
対象を絞り、既存サービスを活用する方法はあります。ただし、原本の内容を承認する人と、権限や同期エラーへ対応する人は必要です。外部へ構築を依頼する場合も、運用責任と引継ぎ範囲を先に決めてください。
まとめ
RAGによる社内データ活用は、文書を入れて終わる取り組みではありません。正本と適用期間を揃え、意味を失わない形で加工し、利用者に許可された根拠から回答を作る設計です。検索と回答を分けた評価に加え、権限変更、文書改訂、削除後の再同期も確認します。
まずは規程や操作マニュアルを1テーマ選び、正本、責任者、閲覧範囲を書き出してください。その文書から答えられる質問と、答えてはいけない質問を並べると、必要な構成が具体的になります。
AI導入に関するお困りごとをサポートします
株式会社NexaのAI顧問は、ツール選定から業務への適用、社内定着までを月額制でサポートします。特定のツールに限らず、「AIをどう使えばいいか分からない」という段階からご相談いただけます。
この記事で参照した外部情報
- MicrosoftのRAG概要learn.microsoft.com
- Microsoftのチャンク分割ガイドlearn.microsoft.com
- Microsoftの公式説明learn.microsoft.com
- Microsoftの文書単位アクセス制御learn.microsoft.com
- Amazon Bedrockの同期手順docs.aws.amazon.com
- AWSの直接削除に関する注意docs.aws.amazon.com
- OWASPのPrompt Injection解説genai.owasp.org
- MicrosoftのRAG評価資料learn.microsoft.com
本文中でリンクしている外部ページの一覧です(自動生成)。最終確認日は本記事の最終更新日 2026-09-09 で、リンク先の内容はその後変わることがあります。