公開日: 最終更新:
公式ドキュメント・公式発表などの一次情報を確認したうえで、株式会社Nexaが執筆・更新しています。AIツールの仕様や料金は変わることがあるため、導入判断の前に各公式サイトの最新情報もご確認ください。運営会社について
Jevは文章ではなく、選択・段階評価・Yesの確率の3形式で判断を返すAIです。業務へ組み込む際は、人の確認へ戻す条件を先に決めます。
- 用途: 問い合わせ分類や優先度判定など、ソフトウェア内の小さな判断に使います。
- 形式: 選択、段階評価、Yesの確率という3種類の質問を組み合わせます。
- 注意: 出力形式の保証は正解の保証ではありません。誤判定への対策は別に必要です。
対象読者:業務自動化を検討するDX推進担当者
今日やること: 自動化したい判断を1つ選び、正解例と保留条件を整理する
Jevは、文章を書くAIではなく、プログラムが使う判断結果を返すモデルです。TypeSafe AIは2026年9月15日、最初の「System One」モデルとして早期アクセスを発表しました。
問い合わせを担当部署に振り分けたいだけなのに、長い回答文や複雑な推論は要らない。Jevは、こうした処理を狙います。ただし、返ってきた値をそのまま業務上の承認に使ってよいわけではありません。企業向けの使いどころと、試す前に決める条件を整理します。
Jevとは?TypeSafe AIが判断向けモデルを発表
Jevは、入力された情報に対して、あらかじめ定めた候補や尺度で答えるモデルです。提供元は、この用途に向けたモデル群を「System One」と呼んでいます。
例えば、問い合わせ文を渡し、回答の候補を「請求」「技術」「営業」と定義します。モデルは候補の選択結果と確率などを返し、周囲のプログラムが担当先を決めます。こうした、値の種類や形を決めたデータが型付きの出力です。自由な文章から部署名を読み取る処理とは異なります。
公式発表によると、提供形態は早期アクセスです。待機リストから開発者を順次案内しており、誰でも直ちに本番利用できる一般提供と同一には扱えません。まずは利用権の有無を確認する段階です。
文章生成型AIとの違いは出力の使い方
Jevは、返答文やコード、判断理由の説明文を生成しません。公式Docsは、自然言語を理解しながら、型付きの判断と確率を返す仕組みと説明しています。
文章生成型の大規模言語モデル(LLM)にも、決めた形式で結果を返す「構造化出力」があります。そのため、「LLMでは分類できない」という意味ではありません。Jevの特徴は、自由な文章生成を用途から外し、小さな判断をソフトウェアへ組み込むことに重点を置く点です。
| 質問形式 | 決めること | 業務での例 |
|---|---|---|
| Choice | 候補の中から選ぶ | 問い合わせの担当部署 |
| Score | 定義した段階に沿って評価する | 問い合わせの深刻度 |
| Noul | Yesである確率を返す | 返金を求めているか |
質問形式の公式説明では、同じ入力に対する独立した質問を、1回の呼び出しで並列評価できます。一方、前の回答を受けて追加資料を取得する場合は、その後に別の呼び出しが必要です。
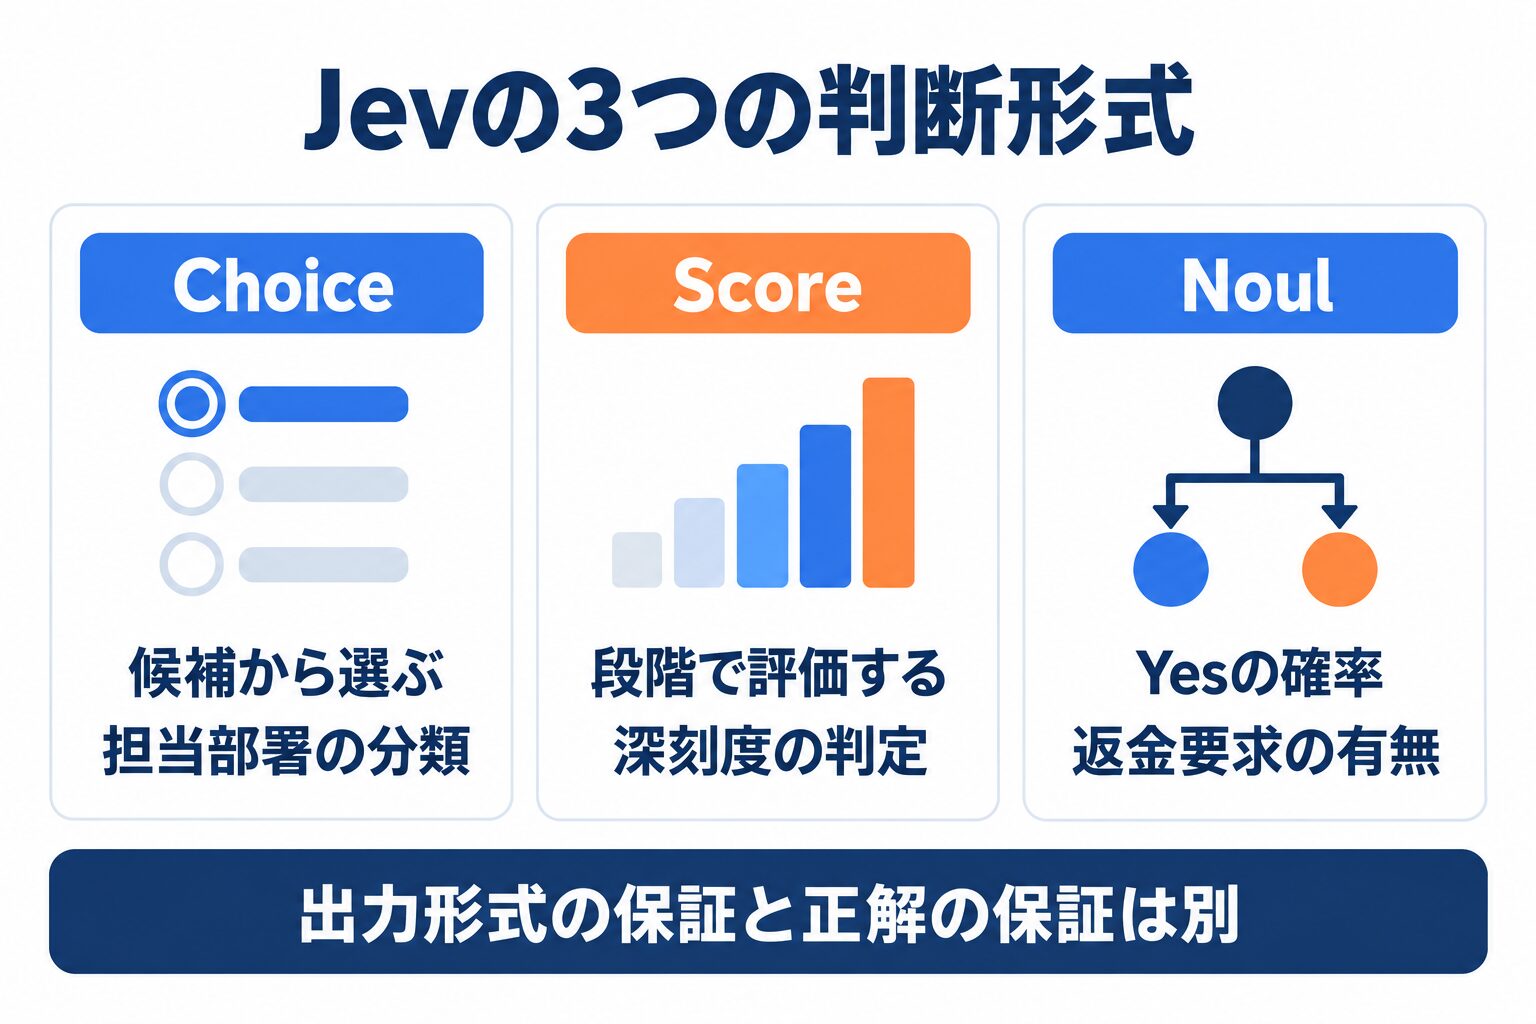 図1: 3種類の質問形式を、部署分類や深刻度の判定に使います。
ChoiceとScoreには、確率分布から計算する確信度の値も付きます。NoulはYesの確率そのものを返し、独立した確信度の項目はありません。まずは出力を「部署名」「段階評価」「該当確率」のどれにしたいかで質問形式を選べます。
企業では問い合わせ分類と確認作業に組み込む
導入候補は、処理全体の自律化より、既存システム内にある判断の一部です。以下は公式の質問形式を業務に当てはめた設計例であり、導入成果の実測ではありません。
- 問い合わせ分類:決めた部署の候補から担当先を選びます。候補に当てはまらない内容のために「その他」も用意します。
- 優先度の判定材料:障害の深刻度と顧客の困り方を別々に評価し、社内ルールで優先度へ変換します。
- 確認対象の抽出:返金要求の有無などを判定し、人が確認すべき案件を一覧にします。
モデルに判断させる範囲と、実際に処理を実行する権限は分けて設計します。例えば「返金を求めている」と判定できても、それだけでは返金を承認できません。購入履歴や規程の照合に加え、必要な人の承認を残します。
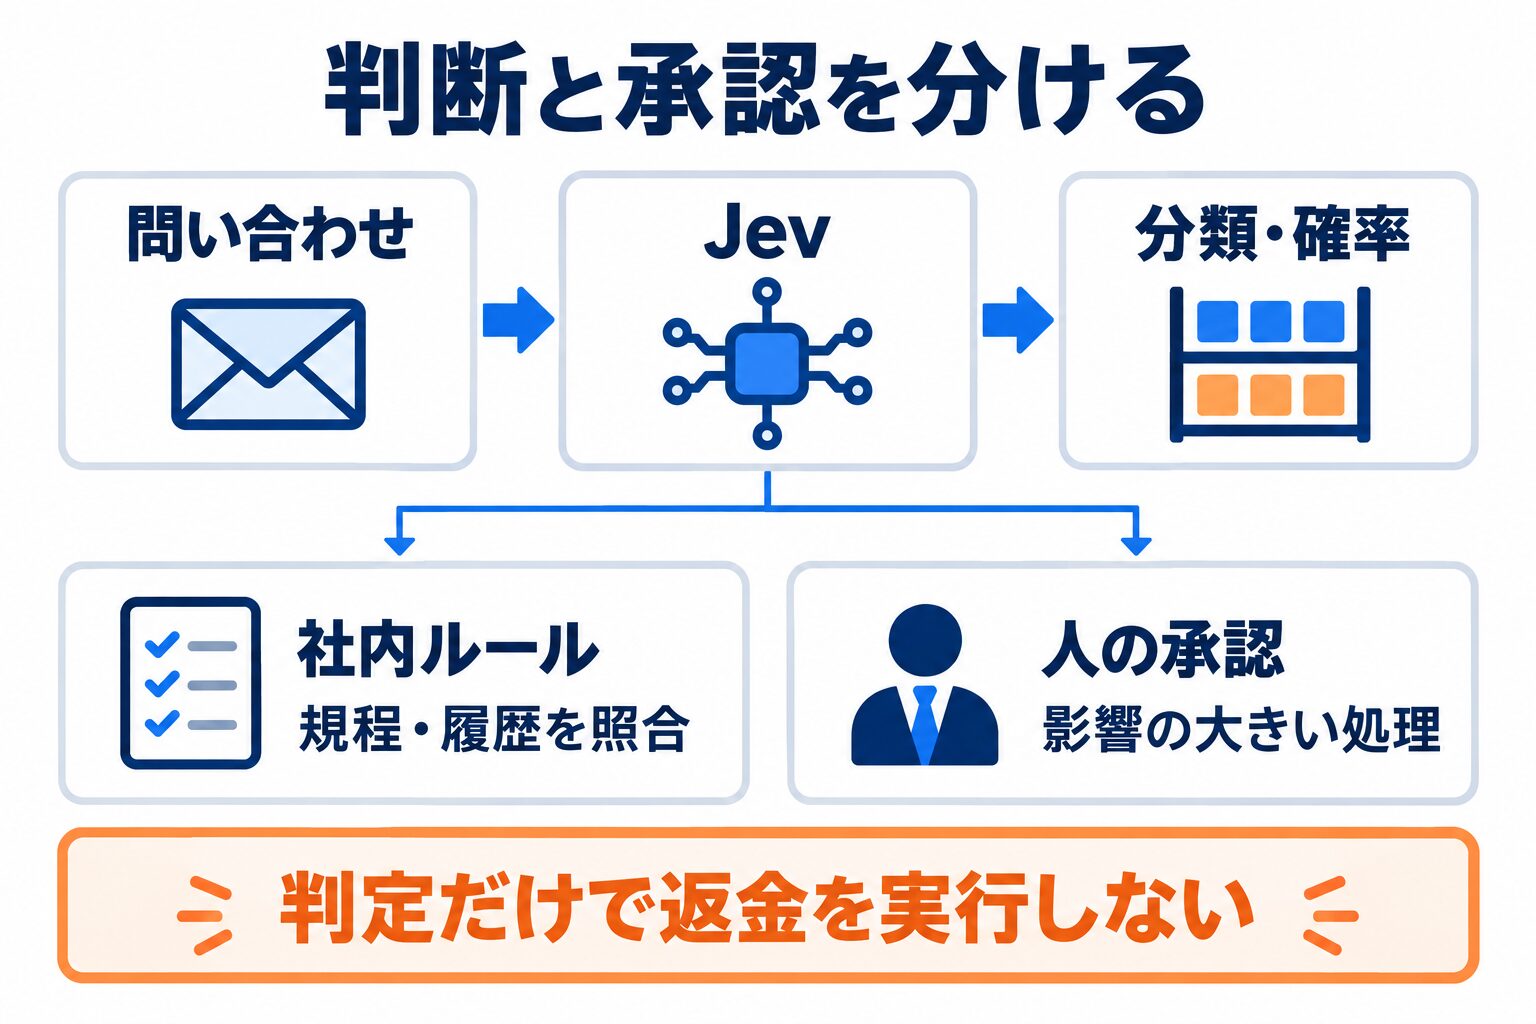 図2: モデルの判断と、社内ルールの照合・人の承認を分けて設計します。
外部サービスを操作するAIエージェントとも役割が異なります。AIエージェントは目的に応じてツールを使う仕組みで、Jevはその中の判断部品として検討できます。背景はAIエージェントの基本でも整理しています。既存ツールを全面的に置き換える前提ではなく、判断が遅い箇所から候補を探してください。
AI導入に関するお困りごとは、株式会社NexaのAI顧問がサポートします。「何から始めればいいか分からない」という段階からご相談いただけます。
料金と提供条件は試験前に確認する
公式モデル一覧では、入力100万トークン当たり0.042米ドル、出力トークンは無料としています(2026年9月23日確認)。トークンは、入力情報をモデルが処理する際の単位です。文章の文字数と一対一では対応しません。これは確認時点のAPI利用料金であり、システム開発や運用を含む総費用ではありません。
速度についても同社は70〜500ミリ秒と説明していますが、評価は主にサービス拠点のある米国西海岸から実施したものです。日本の社内システムからの応答時間や、すべての入力での性能を保証する値ではありません。
試験前には、次の項目を提供元に確認してください。
| 確認項目 | 決めておくこと |
|---|---|
| 利用条件 | 早期アクセスの対象、商用利用の契約条件、利用上限 |
| データ管理 | 保存先、保存期間、学習利用、削除方法 |
| 運用 | 障害時の代替処理、応答時間の要件、担当窓口 |
| 費用 | 入力の長さ、呼び出し頻度、再試行を含めた予算 |
今回参照した発表とDocsだけでは、国内保存や本番向けの稼働保証を確認できません。機密情報や個人情報を投入してよいかは、価格の安さとは別に判断する必要があります。
試すなら自動実行せず人の判断と比較する
最初の試験では、Jevの回答で本番処理を動かさず、人の判断と並べて評価する方法を提案します。分類先を返すだけなら、誤判定してもその場で送信や返金が走らない構成にできます。
- 判断を1つに絞る:例えば問い合わせの部署分類だけにし、候補と「その他」の扱いを決めます。
- 非機密の評価用データを用意する:人が確認した正解例に、曖昧な例や複数の要件を含む例を混ぜます。
- 利用可能ならPlaygroundで比べる:公式Quick startに沿い、入力情報と質問を設定します。日本語の問い合わせは日本語の実務表現で評価します。
- 保留と承認の条件を決める:誤分類率、処理時間、人の確認負荷を記録し、自動化できる範囲を限定します。
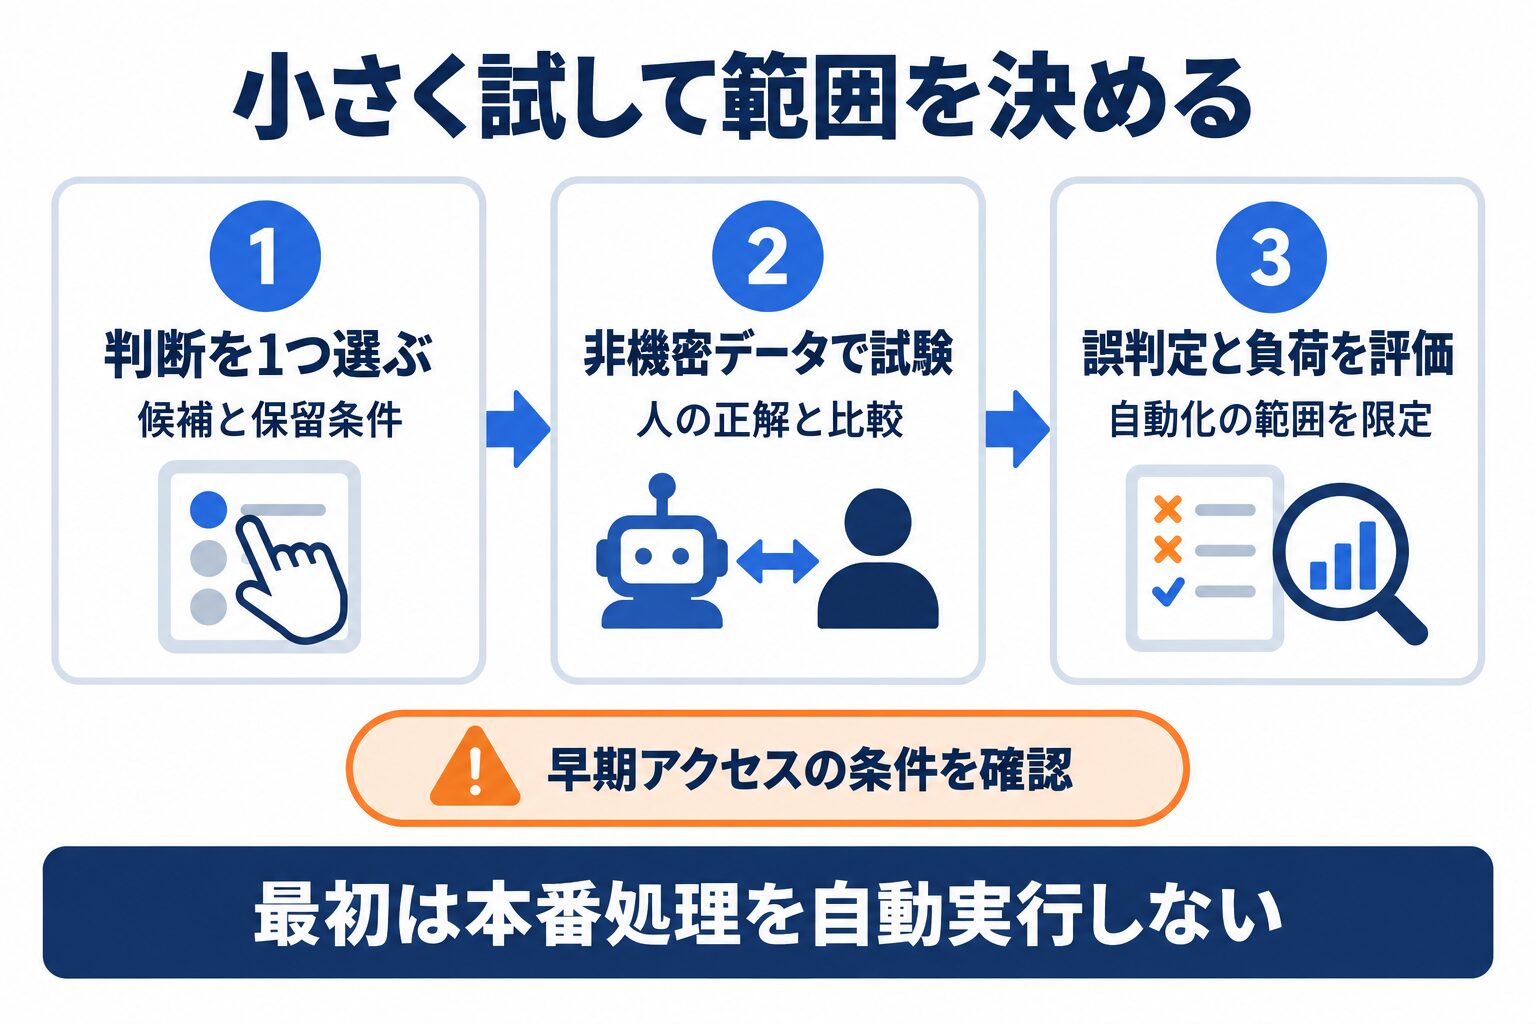 図3: 判断を限定し、非機密データで比較して自動化の範囲を決めます。
公式の確信度ガイドも、閾値は用途とリスクに応じて調整するとしています。確信度は候補への確率の偏りをまとめた値であり、個々の判断の正解保証ではありません。人事評価や支払いなど影響が大きい業務を、単一の数値だけで自動承認する設計は避けます。
評価項目には、判断の正しさだけでなく、送信データと操作権限も含めます。AIセキュリティ診断の確認範囲を参考に、業務部門と情報システム部門で試験の終了条件をそろえてください。
Jevの使い方:APIで判断を取得する手順
Jevは入力情報と質問をAPIへ送り、質問ごとの回答を受け取ります。最初は外部操作につながない環境で試します。
APIは、プログラム同士が決められた形式で情報をやり取りする窓口です。以下は公式Quick startに沿った最小例です。NexaによるJevの推論API実行結果ではなく、読者の検証用サンプルです。利用権と有効なAPIキーを持つ環境で実行してください。
1. Playgroundで入力と質問を分ける
評価対象はstate、判定方法はquestionsに書きます。まずは実在の顧客情報ではなく、架空の短い問い合わせ文で動作を確かめます。
例えば「社内テスト用:接続できず、本日の作業が止まっています」を入力とし、「この文章は緊急性を示していますか」と質問します。質問IDをis_urgentにするだけでは、判断条件の説明になりません。公式Docsは、IDはモデルへ渡されないため、質問自体をinstructionsへ明記するとしています。
2. APIキーを環境変数に設定する
ダッシュボードで取得したキーはTYPESAFE_API_KEYという環境変数で読み込みます。公開リポジトリ、共有資料、ブラウザー側のコードにはキーを書き込まないでください。
次のコードは、キーを設定済みのシェルで実行する前提です。APIの呼び出しには利用料金が発生し得ます。認証できない場合は連続実行せず、キーの有効性とアカウントの利用権を確認します。
3. Noul形式の質問を1件送る
POST /v1/systemoneへ、入力・モデルID・質問をJSON形式で送ります。ここでは再現性のため、確認時点のモデルIDを指定します。
curl --fail-with-body --max-time 30 \
  https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  --data '{
    "model": "jev-1.13.0",
    "state": "社内テスト用:接続できず、本日の作業が止まっています。",
    "questions": {
      "is_urgent": {
        "type": "noul",
        "instructions": "Does this message express urgency?"
      }
    }
  }'
HTTPの成功・失敗を確認したうえで、answers.is_urgent.noulを読みます。値はYesの確率であり、0.5なら「緊急度が中程度」ではありません。緊急であるかについて不確実な状態です。実行結果は入力やモデルに依存するため、ここでは想定値を実測として掲載しません。
4. 回答を記録し、人の判定と照合する
モデルID、質問の版、回答、処理時間、人が付けた正解を記録します。ログに入力全文を残すかどうかは、データ管理規程に合わせて決めます。
部署分類ならChoice、深刻度の段階評価ならScoreを追加できます。同じ入力への独立した質問はまとめて送れますが、取得した回答を前提に外部データを調べる処理は別段階にします。実装時のフィールド定義はHTTP APIリファレンスで確認できます。
モデルIDを固定すると変更の影響を追いやすい
本番検証ではモデルIDを記録し、必要なら版を固定します。別名で呼び続けると、更新後に判断結果が変わり得ます。
公式モデル一覧では、2026年9月23日の確認時点でjev-1.13.0が掲載されています。jev-latestとjev-previewも同じ版を指していますが、将来も同じとは限りません。公式Docsは、応答のmodelで実際に回答した版を確認できると説明しています。
使い始めに別名を選ぶこと自体は問題ありません。ただし、保留条件を調整した後に版が変わると、同じ閾値のままでよいか再評価が必要です。モデル更新時は評価用データを再実行し、誤判定率と人の確認件数を比較してください。
日本語対応と入力制限は別々に確認する
Jevは日本語も扱いますが、英語と同等の精度は保証されません。画像や音声をそのまま入力するモデルでもありません。
公式モデル一覧では、英語が主な学習言語で、現状では英語の精度が最も高いとしています。日本語の略語、敬語、主語の省略、否定の言い回しは、実際に使う表現で検証します。「急ぎではありません」を緊急と誤判定しないかなど、境界の例を含めてください。
同ページで確認できる入力はテキストです。画像・音声・動画は、そのまま渡すのではなく、別の仕組みでテキストや必要な項目へ変換します。確認時点のコンテキスト上限はリクエスト全体で64kトークン、stateと最長の質問の合計で32kトークンです。上限まで詰め込むことと精度の維持は別問題です。
判断の材料は必要な情報だけに絞る
入力には判断に必要な根拠を含め、無関係な履歴は外します。情報不足と過剰入力の両方を避ける設計が必要です。
例えば部署分類なら問い合わせ本文と分類先の定義が中心です。返金の規程適合を調べるなら、対象取引と適用規程も必要になります。ただし、関係のない別顧客の履歴まで送る理由はありません。Stateの公式説明に沿い、入力を項目ごとに整理すると質問が参照する範囲を明確にできます。
Jev 1.13の既知の弱点には、数値計算、日時比較、無関係な情報が多い入力などが挙がっています。期限判定や合計金額はプログラムで計算し、Jevには文章の意味に関わる判断を任せます。「何でもモデルに聞く」より、通常のコードと役割を分ける方が検証しやすくなります。
確率とconfidenceを同じ数値として扱わない
Choiceの選択肢の確率とconfidenceは異なる指標です。Noulには独立したconfidenceがない点にも注意します。
Choiceのprobabilitiesは候補ごとの確率分布です。一方、confidenceは分布の偏りを1つの数値へまとめたものです。選択された候補の確率を、そのままconfidenceとして扱うことはできません。実装では、どちらの値を条件にしているか、変数名とログで区別します。
「confidenceが0.9なら、この1件は90%の確率で正しい」と単純に読み替えないでください。校正は複数の予測をまとめて評価する性質であり、個々の正解を保証しません。閾値を設定する前に、誤分類した場合の影響と、人が確認できる件数を決めます。
Nexaの実測:合成データ7件で保留分岐をローカル検証
Nexaは判断後の分岐をPythonで試験し、7件が想定どおりに分かれることを確認しました。Jevの精度測定ではありません。
2026年9月23日、外部APIに接続しないローカル環境で実行しました。以下の値は分岐の境界を試すために作ったテスト入力で、Jevの応答を取得したものではありません。実顧客のデータも使用していません。検証対象は、モデルの判断を受け取った後に動くアプリ側の安全策です。
今回の例では「許可した部署」「0〜1の有効な数値」「confidenceが0.9以上」を満たす場合だけ、振り分け候補にしました。「その他」、数値の欠落・範囲外、承認が必要な処理は、人の確認へ回します。0.9はこのコード例の仮の閾値であり、Jevの推奨値でも、検証済みの最適値でもありません。
| 試験条件 | ローカル実行結果 |
|---|---|
| 許可した部署、confidence 0.95 | 振り分け候補 |
| 許可した部署、confidence 0.89 | 人の確認 |
| 許可した部署、confidence 0.90 | 振り分け候補 |
| 「その他」、confidence 0.99 | 人の確認 |
| confidenceが欠落 | 人の確認 |
| confidenceが1.2で範囲外 | 人の確認 |
| 承認が必要な処理、confidence 0.99 | 人の確認 |
結果は振り分け候補2件、人の確認5件でした。送信・支払いなどの処理は実行せず、分岐結果だけを確認しています。この試験で確かめたのは、欠損値や承認必須条件で自動処理へ進めないことです。Jevが日本語を正しく分類できるか、応答時間が何秒か、実務で何件削減できるかは測定していません。
本番前には、このようなコードの境界試験に加えて、モデルへ非機密の日本語サンプルを送り、人の正解と比べる評価が必要です。高いconfidenceでも誤る例を探し、確認が必要な処理を明示的に残してください。
エラー時は無条件に繰り返さず確認へ戻す
通信失敗や上限超過では回答が得られない前提で設計します。応答がない状態を、否定の判定として扱ってはいけません。
公式モデル一覧では、レート制限を超えるとHTTP 429が返り、SDKは待ち時間を増やす再試行に対応するとしています。上限は動的に変更され得るため、固定値だけに依存しないでください。HTTP APIを直接使う場合は、retry-afterなどの応答情報と最大再試行回数を考慮します。
タイムアウト、認証エラー、回答項目の欠落は「人の確認」や既存ルールに戻す条件です。同じ案件を再試行しても、二重に送信や支払いが走らないよう、判定と実行を別の工程にします。実行処理には案件IDによる重複防止も必要です。
導入判断は精度・費用・データ管理で行う
採用は料金だけで決めず、業務上の誤りと人の確認負荷で判断します。データの学習利用と保存条件も分けて確認します。
公式Legalページはユーザーデータを学習に使わない方針と、企業向けのゼロデータ保持の提供を案内しています。ただし、学習に使わないことが、すべての契約で保存されないことを意味するわけではありません。データ処理契約、保持条件、削除方法を利用形態に合わせて確認します。
判定モデルを既存のAIエージェントへ組み込む場合、LangChain公式のJev解説も参考になります。同記事はTypeSafeClassifierによる連携を紹介し、文章生成を担うLLMの代替ではなく補完として整理しています。導入時は、現在の分類方式との誤りの差、総費用、運用担当者が保守できるかを比較してください。
Jevのよくある質問
Q. Jevでメール本文やコードを作れますか?
公式Docsでは、文章やコード、推論の説明文を生成しないとしています。問い合わせ分類と返信文作成を組み合わせる場合、後者には文章生成モデルなど別の手段が必要です。
Q. 型が保証されるなら、間違えないのでしょうか?
いいえ。型の保証は、定義した候補や形式に沿うという意味です。誤った部署を選ぶ可能性とは別です。公式Docsも、確率の校正は予測の集合で評価するもので、個々の回答の正しさを保証しないと説明しています。
Q. 日本企業でもすぐ使えますか?
早期アクセスの利用権が前提です。今回確認した資料だけでは、日本語業務での精度や日本国内でのデータ保存を保証できません。利用条件を確認し、非機密の日本語サンプルで評価してから適用範囲を決めてください。
まとめ
Jevの発表は、文章生成だけでなく、プログラムが直接使う判断に特化したAIを選ぶ機会が増えたことを示します。分類や段階評価には使いどころがありますが、文章作成や複雑な説明まで代替するモデルではありません。
企業が最初に進めることは、問い合わせ分類など判断を1つ選び、正解例と保留条件をそろえることです。早期アクセス、データ管理、商用利用条件を確認したうえで、人の判断と比較する試験から始めてください。
AI導入に関するお困りごとをサポートします
株式会社NexaのAI顧問は、ツール選定から業務への適用、社内定着までを月額制でサポートします。特定のツールに限らず、「AIをどう使えばいいか分からない」という段階からご相談いただけます。
この記事で参照した外部情報
- 公式発表typesafe.ai
- 公式Docsdocs.typesafe.ai
- 質問形式の公式説明docs.typesafe.ai
- 公式モデル一覧docs.typesafe.ai
- 公式Quick startdocs.typesafe.ai
- 公式の確信度ガイドdocs.typesafe.ai
- HTTP APIリファレンスdocs.typesafe.ai
- Stateの公式説明docs.typesafe.ai
- Jev 1.13の既知の弱点docs.typesafe.ai
- 公式Legalページdocs.typesafe.ai
- LangChain公式のJev解説langchain.com
本文中でリンクしている外部ページの一覧です(自動生成)。最終確認日は本記事の最終更新日 2026-09-23 で、リンク先の内容はその後変わることがあります。
AI導入を検討中の方へ